讲讲attention 的理解
传统的这个序列建模,难以捕捉输入部分不同序列的重要性,比如RNN和CNN,Attetion 机制引入一种动态计算权重的方式,对输入序列不同部分进行加权求和,得到当前时间步输出,进而得到对不同部分的关注度的自适应调整。
attention的计算步骤是什么
$$ \text{Attention}(Q,K,V) = \text{softmax}\left(\frac{QK^\top}{\sqrt{d_k}}\right)V $$
其中 softmax 公式为:
$$ \text{softmax}(z_i) = \frac{e^{z_i}}{\sum_{j=1}^{n} e^{z_j}} $$
作用:把任意实数向量转成概率分布(所有值为正且和为1),数值越大的项获得越高的权重。除以 √dk 是为了防止点积数值过大导致 softmax 进入饱和区、梯度消失。
(2)模型架构——Encoder Only
BERT 的模型架构是取了 Transformer 的 Encoder 部分堆叠而成,其主要结构如图3.1所示:
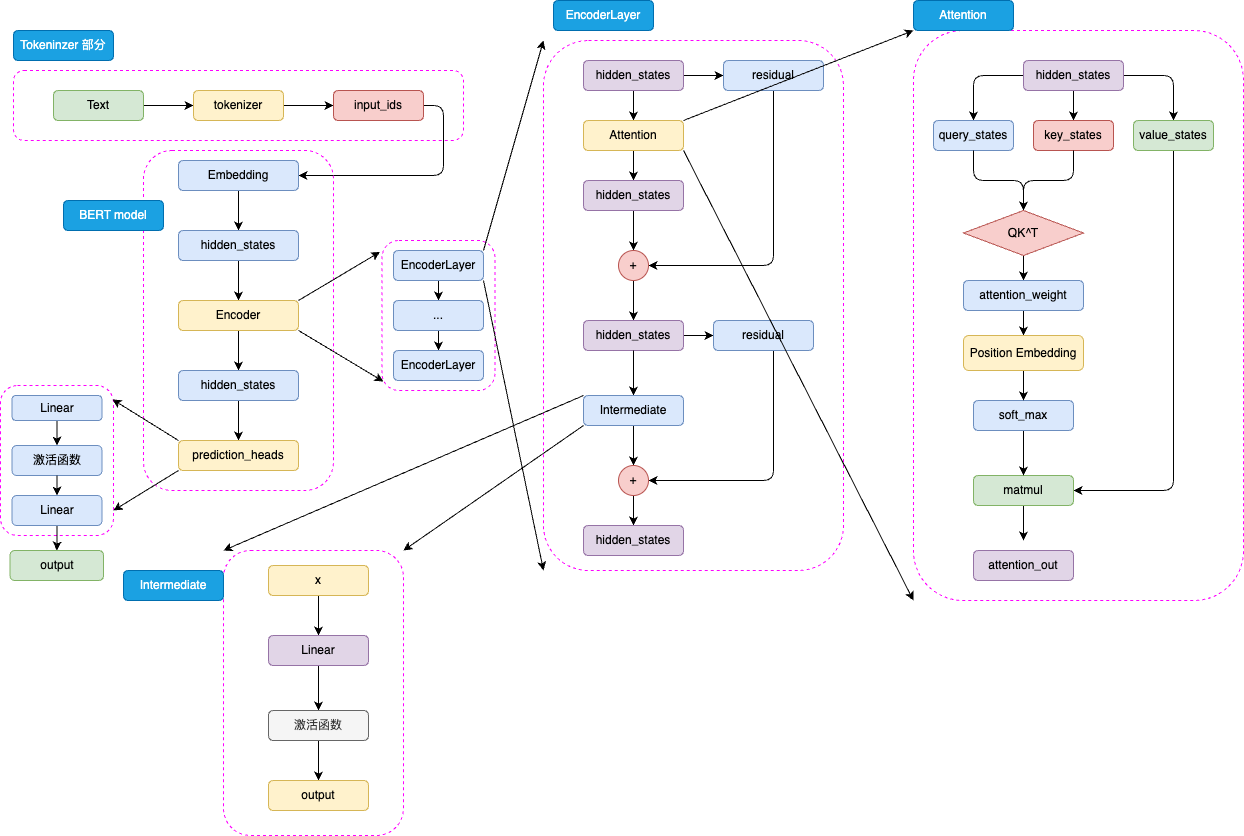
图3.1 BERT 模型结构
BERT 是针对于 NLU 任务打造的预训练模型,其输入一般是文本序列,而输出一般是 Label,例如情感分类的积极、消极 Label。但是,正如 Transformer 是一个 Seq2Seq 模型,使用 Encoder 堆叠而成的 BERT 本质上也是一个 Seq2Seq 模型,只是没有加入对特定任务的 Decoder,因此,为适配各种 NLU 任务,在模型的最顶层加入了一个分类头 prediction_heads,用于将多维度的隐藏状态通过线性层转换到分类维度(例如,如果一共有两个类别,prediction_heads 输出的就是两维向量)。
模型整体既是由 Embedding、Encoder 加上 prediction_heads 组成:
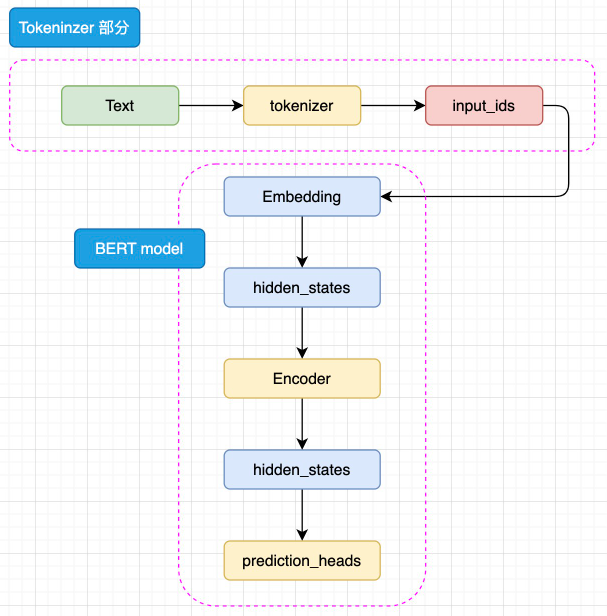
图3.2 BERT 模型简略结构
输入的文本序列会首先通过 tokenizer(分词器) 转化成 input_ids(基本每一个模型在 tokenizer 的操作都类似,可以参考 Transformer 的 tokenizer 机制,后文不再赘述),然后进入 Embedding 层转化为特定维度的 hidden_states,再经过 Encoder 块。Encoder 块中是堆叠起来的 N 层 Encoder Layer,BERT 有两种规模的模型,分别是 base 版本(12层 Encoder Layer,768 的隐藏层维度,总参数量 110M),large 版本(24层 Encoder Layer,1024 的隐藏层维度,总参数量 340M)。通过Encoder 编码之后的最顶层 hidden_states 最后经过 prediction_heads 就得到了最后的类别概率,经过 Softmax 计算就可以计算出模型预测的类别。
BERT 采用 WordPiece 作为分词方法。WordPiece 是一种基于统计的子词切分算法,其核心在于将单词拆解为子词(例如,"playing" -> ["play", "##ing"])。其合并操作的依据是最大化语言模型的似然度。对于中文等非空格分隔的语言,通常将单个汉字作为原子分词单位(token)处理。
prediction_heads 其实就是线性层加上激活函数,一般而言,最后一个线性层的输出维度和任务的类别数相等,如图3.3所示:
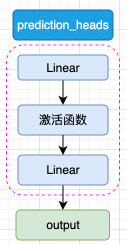
图3.3 prediction_heads 结构
而每一层 Encoder Layer 都是和 Transformer 中的 Encoder Layer 结构类似的层,如图3.4所示:
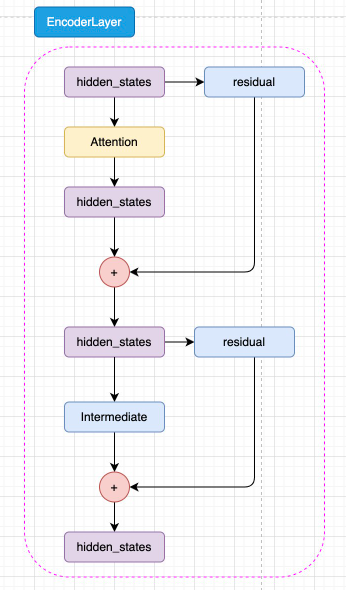
图3.4 Encoder Layer 结构
如图3.5所示,已经通过 Embedding 层映射的 hidden_states 进入核心的 attention 机制,然后通过残差连接的机制和原输入相加,再经过一层 Intermediate 层得到最终输出。Intermediate 层是 BERT 的特殊称呼,其实就是一个线性层加上激活函数:
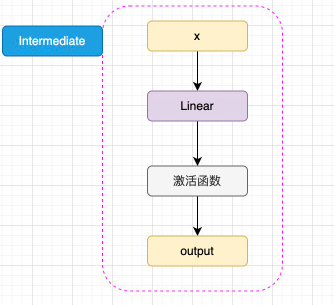
图3.5 Intermediate 结构
注意,BERT 所使用的激活函数是 GELU 函数,全名为高斯误差线性单元激活函数,这也是自 BERT 才开始被普遍关注的激活函数。GELU 的计算方式为:
$$GELU(x) = 0.5x(1 + tanh(\sqrt{\frac{2}{\pi}})(x + 0.044715x^3))$$
GELU 的核心思路为将随机正则的思想引入激活函数,通过输入自身的概率分布,来决定抛弃还是保留自身的神经元。关于 GELU 的原理与核心思路,此处不再赘述,有兴趣的读者可以自行学习。
BERT 的 注意力机制和 Transformer 中 Encoder 的 自注意力机制几乎完全一致,但是 BERT 将相对位置编码融合在了注意力机制中,将相对位置编码同样视为可训练的权重参数,如图3.6所示:
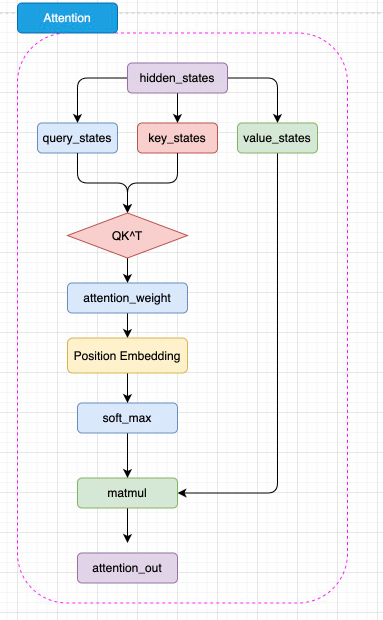
图3.6 BERT 注意力机制结构
如图,BERT 的注意力计算过程和 Transformer 的唯一差异在于,在完成注意力分数的计算之后,先通过 Position Embedding 层来融入相对位置信息。这里的 Position Embedding 层,其实就是一层线性矩阵。通过可训练的参数来拟合相对位置,相对而言比 Transformer 使用的绝对位置编码 Sinusoidal 能够拟合更丰富的相对位置信息,但是,这样也增加了不少模型参数,同时完全无法处理超过模型训练长度的输入(例如,对 BERT 而言能处理的最大上下文长度是 512 个 token)。
注:原始 BERT(即论文提出)使用和 Transformer 一致的绝对位置编码,后续改进(包括 BERT 的各种变体)使用了上述相对位置编码,为帮助读者了解更全面的模型结构设计,此处选择了改进版 BERT。
可以看出,BERT 的模型架构既是建立在 Transformer 的 Encoder 之上的,这也是为什么说 BERT 沿承了 Transformer 的思想。
如何理解 Attention 机制?它是怎么计算的
Attention(注意力)机制的核心思想是:在处理序列中的某个位置时,动态地为序列中的所有位置分配权重,再按权重对信息加权求和。权重越高,代表当前位置越“关注”那个位置。它是 Transformer 以及当今大模型的基础。
一、为什么需要 Attention
在 Attention 出现之前,序列建模主要用 RNN 和 CNN:
- RNN 按顺序逐个处理,远距离的信息要经过很多步传递,容易被稀释,也无法并行计算。
- CNN 只能看到卷积核覆盖的局部窗口,要捕捉长距离依赖必须堆很多层。
两者都难以根据内容判断“输入中哪些部分更重要”。Attention 则让每个位置都能直接和其他任意位置建立联系,并按相关程度自适应地分配关注度。
比如句子“小猫没有吃鱼,因为它不饿”,在处理“它”时,模型会给“小猫”分配较高的权重,从而理解指代关系。
二、计算步骤
最常用的是缩放点积注意力:
$$ \text{Attention}(Q,K,V) = \text{softmax}\left(\frac{QK^\top}{\sqrt{d_k}}\right)V $$
可以拆成四步:
- 生成 Q、K、V:输入向量 X 分别乘以三个可学习的矩阵,得到 Query(查询)、Key(键)、Value(值)。可以类比检索:Q 是“我要找什么”,K 是“我有什么标签”,V 是“我的实际内容”。
- 计算相关性分数:用 Q 和每个 K 做点积,得到 $QK^\top$,分数越大表示越相关。
- 缩放并归一化:除以 $\sqrt{d_k}$,再经过 softmax 转成概率分布。
- 加权求和:用这些权重对 V 加权求和,得到输出。
其中 softmax 的公式为:
$$ \text{softmax}(z_i) = \frac{e^{z_i}}{\sum_{j=1}^{n} e^{z_j}} $$
它把任意实数向量变成全部为正、总和为 1 的权重,分数大的项权重也大。
三、为什么要除以 √dk
当向量维度 $d_k$ 较大时,点积结果的方差也会随之变大,数值可能非常大。softmax 输入过大会进入饱和区,输出接近 one-hot,梯度几乎为零,训练难以进行。除以 $\sqrt{d_k}$ 能把点积的方差拉回到 1 左右,保持梯度稳定。
四、代码示意
import torch, math

def attention(q, k, v, mask=None):
    d_k = q.size(-1)
    scores = q @ k.transpose(-2, -1) / math.sqrt(d_k)
    if mask is not None:
        scores = scores.masked_fill(mask == 0, float("-inf"))
    weights = torch.softmax(scores, dim=-1)
    return weights @ v
mask 用于解码器的因果注意力:把未来位置的分数置为负无穷,softmax 后权重为 0,保证生成时看不到后面的词。
五、常见扩展
- Self-Attention:Q、K、V 都来自同一个序列,用来捕捉序列内部的依赖关系。
- Cross-Attention:Q 来自解码器,K、V 来自编码器,用于翻译等任务。
- Multi-Head Attention:把 Q、K、V 拆成多个头分别计算再拼接,让模型从不同子空间捕捉不同类型的关系。
总结
Attention 通过 Q 与 K 的相似度计算权重,再对 V 加权求和,让模型能直接关注序列中任意位置的重要信息,解决了 RNN 长距离依赖弱、无法并行的问题。除以 $\sqrt{d_k}$ 是为了避免 softmax 饱和导致梯度消失。
📮 联系方式
微信:BuZhiCoder | QQ:1776418445 扫码添加,备注「求职」优先通过